标签归档:AI

真正的工业革命,正在第二次发生

年初的时候写了一篇《AI将如何重塑这个世界》,现在半年过去,国务院办公厅发文称要「有效减缓人工智能应用就业替代影响」。AI 对世界的影响似乎比大多数人预期的还要快,对此中国政府也是高度重视的。

就通常说法而言,到目前为止有四次工业革命。

第一次工业革命(18世纪60年代起):蒸汽时代。
第二次工业革命(19世纪70年代起):电气时代。
第三次工业革命(20世纪中期起):信息时代。
第四次工业革命(21世纪初至今):智能时代。

但在我看来只有第一次工业革命才算是真正的跨越,后面所谓的三次工业革命只是第一次工业革命的延续。只有 ChatGPT 出现带来的 AI 的广泛应用,才能匹配第一次工业革命的跨越度。第一次工业革命带来的变革是普通劳动力不再稀缺,这次 AI 的出现则让普通的智力不再稀缺。

虽然 ChatGPT 的出现才短短几年,但正在飞速地重构整个产业结构。AI 能力可以不是顶级,但一旦越过一个阈值,对行业的重构可以在很短的时间内完成。绘画、配音、视频、编程都越过了这个阈值。低端的插画行业早在前两年就已经沦陷。短视频网站上 AI 配音的视频占了绝大多数。SeedDance 2.0 的出现将刚兴起的真人短剧行业撞飞。Vibe Coding 开始成为主流,说是成倍提升开发效率都是保守。就连人类引以为傲的数学领域也被接连攻陷。

在 AI 成倍提升工作效率的同时并没有创造新的需求。就以软件行业为例,在 AI 成倍提升软件开发效率的同时,人们对软件的需求其实是减少的。以前很多需要依赖复杂软件实现的工作都可以交给 AI 来完成。一定程度上 AI 不是创造需求,反而减少了需求。

这次AI技术的成熟建立在人类前期积累的智力资料之上,这些资料里有糟粕和真正有价值的。AI的训练则犹如挖矿。随着AI的发展部分“天才”可以超越AI,优秀的人可以产出智力产品让AI继续训练,大量的普通人的智力产出的只是废矿,连做“人矿”的资格都没有。

AI 正在平等的撞飞每个相关的行业,甚至可以说是每个人。AI 对产业和社会的影响必将是结构性的。

社会的本质其实还是分配制度。生产力的提升后让物质得到了丰富,但如何分配制度没有跟上必将导致社会危机。这就是马克思主义里的生产力决定生成关系,以及经济危机产生的原因。生产出的产物本质还是需要有人来消费,如果AI的发展带来的生产力提升反而导致了大量失业,产出无人消费必将复现当年的经济危机。

第一次工业革命,如果以关键机器发明为起点、以社会危机爆发为节点来算,中间大约隔了 40—50年。这次 AI 的普及速度是远快于第一次工业革命的,对社会的冲击必定不比第一次工业革命低。留给各国政府解决问题的时间也远比第一次工业革命时少。

不过我并不认为新一轮的社会危机必将爆发。社会学已经发展多年,各国政府应当都有在积极地准备相应的对策(虽然这并不容易)。至少就中国政府而言,这会是当前的一项非常重要的工作。

未来的社会会怎么样,我不知道,或许也没有人会知道。时代的一粒沙,落在人身上是座山。或许我们能做的只有认真生活,同时相信政府。

AI将如何重塑这个世界

一、AI进化的悖论

AI的发展高度依赖其训练所用的语料。互联网的蓬勃发展为AI提供了海量且高质量的训练素材。然而,随着AI的普及,大量由AI生成的低质量内容开始反噬互联网,造成严重的信息污染。内容的数量在激增,但整体质量却在下降。寻找纯净、高质量的语料库,正变得前所未有的困难。

二、传统编程技术的末路?

随着AI技术的突破,“vibe coding”已进入实用阶段。或许在不久的将来,新入行的编程人员只需要掌握这种交互方式即可,而传统的编程语言则会像如今的汇编语言一样,退居幕后,只需少数专业人士掌握。

对于新兴的编程语言和框架而言,由于AI对其不够熟悉、难以熟练运用,可能陷入无人问津的恶性循环,最终难以发展。除非新的编程技术从一开始就围绕“如何让AI高效使用”来设计,否则很难获得成长空间。近年来,Go、Rust、TypeScript、Swift等语言蓬勃发展,本以为是高级语言新一轮演进的开始,没想到却遇到了AI这个分水岭。或许,它们就是最后一代能被广泛使用的高级语言了。

AI阅读代码的速度远超人类,但它也有自身的极限。大多数软件在代码彻底失控之前,可能就已经寿终正寝了。对于一些简单的应用,纯“vibe coding”或许不是问题;但对于复杂的软件系统,如果任由AI不断堆砌代码,最终形成的“屎山”就连AI自己也会无能为力。

如果“vibe coding”成为主流编程方式,低质量代码对语料库的污染,将远比其他领域的知识污染更为严重。

三、生产力革命与社会结构重塑

回顾历次技术革命,其本质都是对人类劳动的替代。工业革命用机器取代了体力劳动,机械技术的发展使得普通手工业者无论如何努力,其生产效率和质量都无法与机器抗衡,因此市场只留下了少数满足个性化需求的“匠人”。这些被释放的人力,最终流入了脑力行业和第三产业。

今天的AI革命则更进一步,开始取代人的智力劳动。类似地,AI的发展也将使大多数智力平平者难以企及AI的能力,智力劳动领域同样只需保留少数顶尖的“匠人”。然而,这一次被释放的大量脑力工作者,似乎还没有找到合适的承接领域。

经济活动最终要服务于人的消费。如果生产力的提升导致大量人口失业,就必须建立新的分配规则,否则将引发生产过剩的经济危机,进而导致大萧条。生产力决定生产关系,当AI将生产力推升到一个新高度时,旧有的生产关系必然面临调整。

如果不能妥善应对AI带来的这一系列挑战,现有的社会秩序很可能面临崩溃的风险。

一个AI公司需要多少人

Stable Diffusion 和 ChatGPT 的大火,让沉寂已久的AI世界再次翻红。又开始有人在问,在AI越来越成熟的今天,程序员是否有必要去学算法,投身AI行业。在我看来对程序员而言AI带来的机会更多是如何利用AI带来的能力而不是去创造一个AI。

曾在AI公司待过一段时间,这段经历给我最大的感觉是: AI 行业是一个资本密集型产业,对普通程序员来说没太多的机会。AI的发展对普通程序员带来的最大变化是出现来一批很好用的 API ,可以实现一些以前实现不了的想法。另外就是如何利用新出现的一批AI工具提高自己的工作效率。

为什么不建议普通程序员进入AI行业

简单来说AI行业需要的专业算法人员非常少,且门槛非常高。非算法相关的人员,相对而言门槛又太低。

  1. 常规应用,通用模型已经很成熟了。对于 99.9%人根本不可能构建出一个比开源模型更好的模型。
  2. 模型的性能优化是个体力活,而且随着技术的发展,以后可能不需要手动的性能优化。
  3. 模型的调优需要大量的数据和硬件。数据清洗是和 AI 没关系的纯体力活。参数调优又需要大量的硬件,¥成本普通人(公司)根本承担不起(据说 ChatGPT 训练一次的成本就高达 1 千万美元)。

一个AI公司需要多少人

前面说到AI公司需要的人少,但具体少到什么程度可能会超乎很多人的想象。

OpenAI

OpenAI(ChatGPT 的母公司),仅2022年,就花费了约5.44亿美元。而与之对应的是”今年1月,OpenAI创始人透露公司员工人数为375人“。关键是这375人里包含了行政等支持人员及数据收集整理人员。

Midjourney

相比 OpenAI ,AI绘图领域的巨头 Midjourney 在人力方面更是做到了极致。Midjourney 总共只有11人:1创始人,1财务,1法务,8研发(其中4人为本科实习生)。

参考

使用AI修复将画像还原成照片

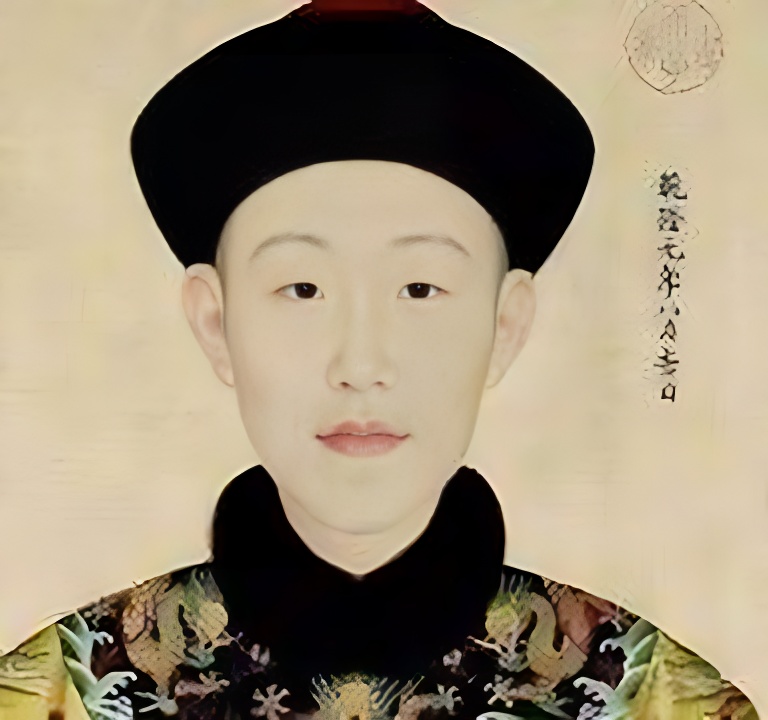
GFPGAN 是一个使用 AI 进行人脸修复的工具,即使对非常模糊的人脸也可起到不错的修复效果。Hugging Face 提供了AI应用Demo的快速部署。我 Fork 了一份 GFPGAN 的 Demo 并做了少量的调整以加强对图片的支持。

在线体验地址 https://huggingface.co/spaces/vicalloy/GFPGAN

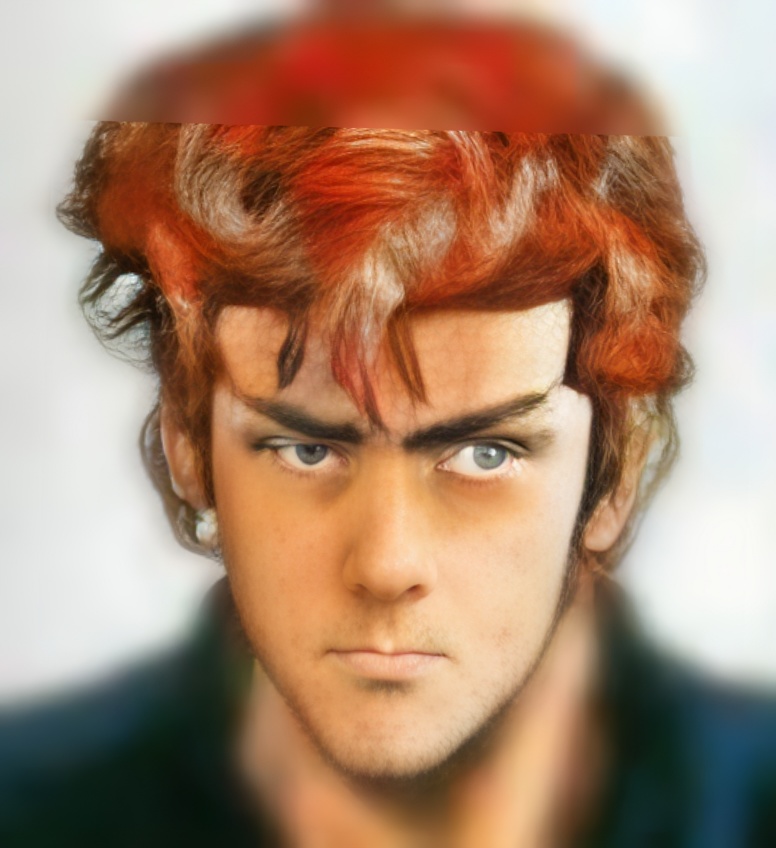
AI技术在图片生成领域有了不错的进展,现在已经可以通过文字生成质量不错的图片了。之前就一直想尝试用AI人脸修复将画中的人脸修复成照片,只是迫于拖延症一直未能真正动手。这些天试了一下,发现这个想法切实可行,就是修复出的效果算不上出色。

Tips

  1. AI 照片修复实际上是让 AI 对图片进行自行“脑补”的一个过程,所以原图细节一定不能过多(图片一定要小,或是),不然不利于 AI 软件的自行发挥。
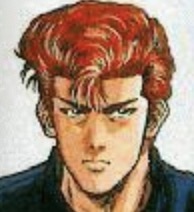
  2. 樱木花道的输出效果不太好,再小丢失的细节又过多,因此加了个高斯模糊。注:理论上加高斯模糊比单纯的缩小图片效果要好,大家可以对其他图片试试。
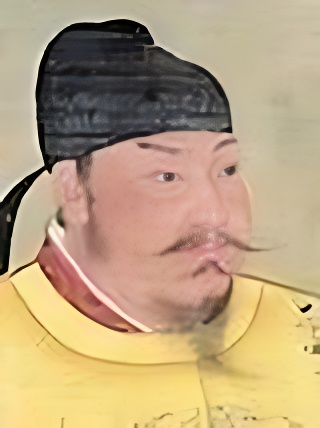
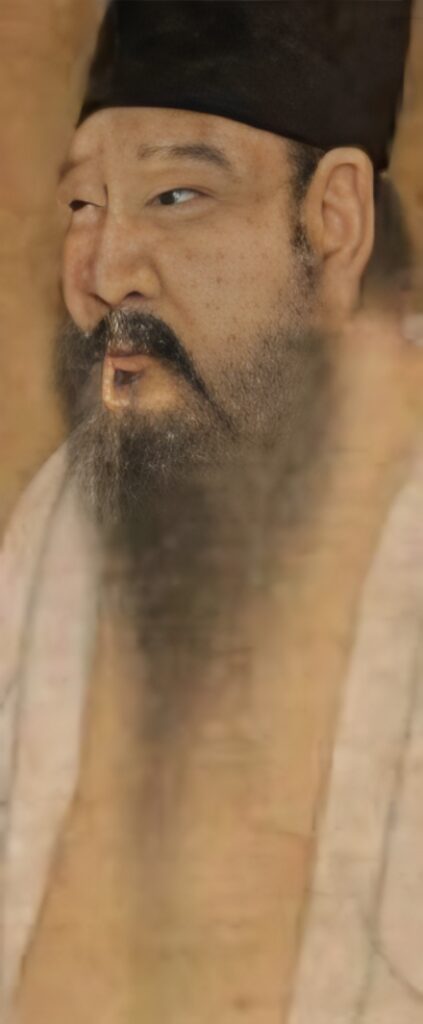
  3. 应当是缺少样本,外加人脸检测时,如果胡子过长截取人脸时会丢失部分胡子。古人的长须无法完整修复。
  4. 过于“漫画化”的图片是无法识别到人脸的。

效果

樱木花道

唐太宗李世民

乾隆

韩熙载

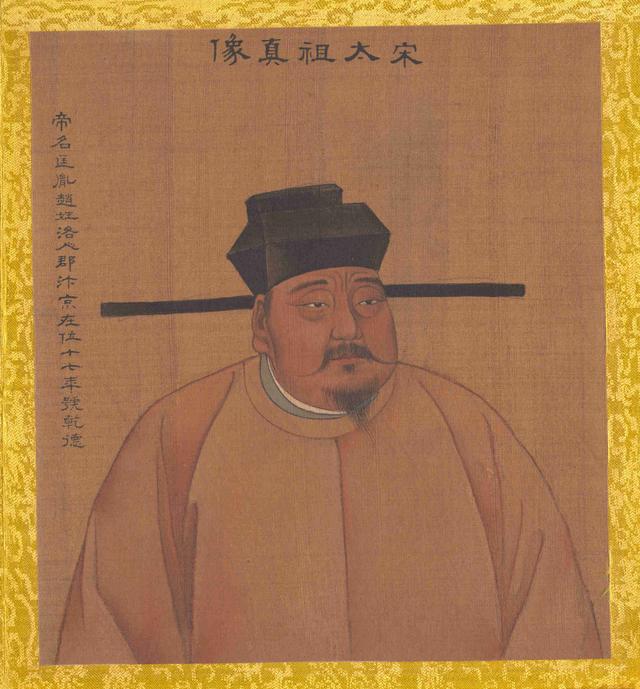
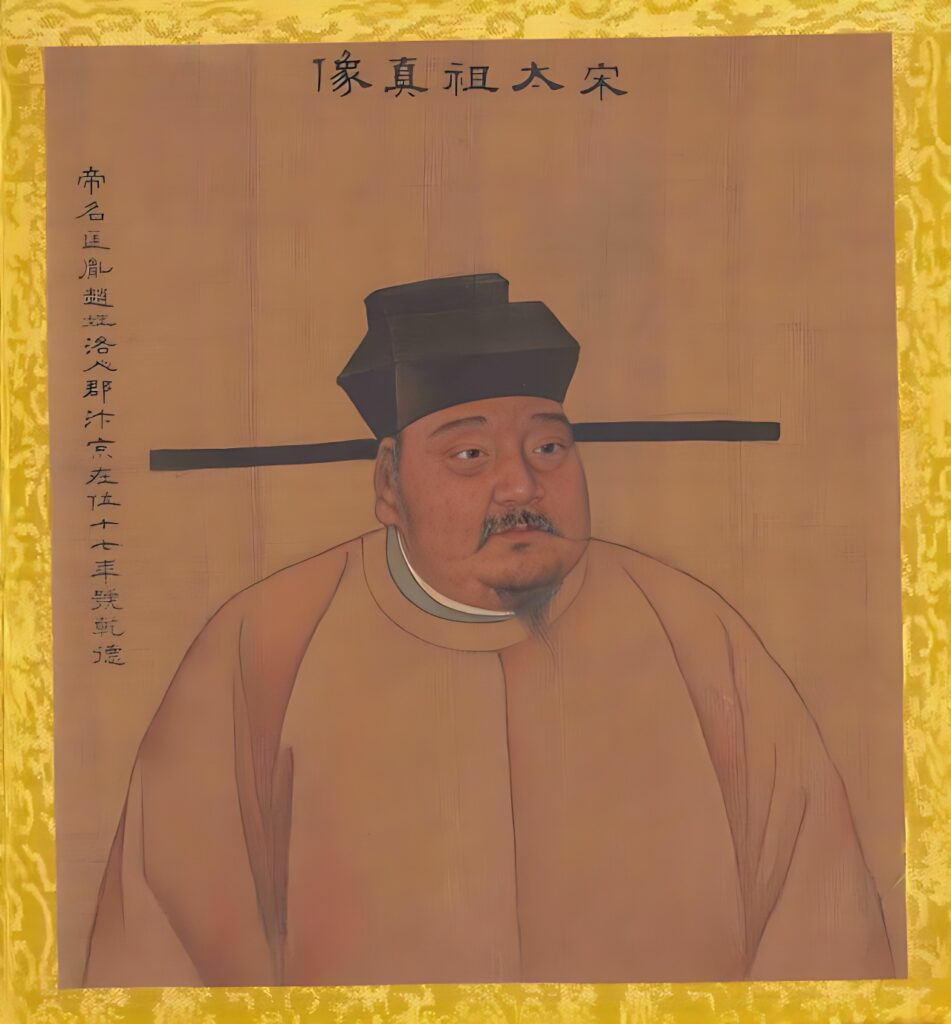
宋太祖赵匡胤

将OpenVINO预训练模型转为为ONNX,并使用TVM进行优化

OpenVINO是Intel推出的一款深度学习工具套件。OpenVINO带来大量的预训练模型,使用这些预训练模型可以快速的开发出自己的AI应用。

不过既然是Intel出的东西,自然少不了和Intel平台深度绑定。OpenVINO主要针对Intel的CPU进行优化。虽然也可以支持GPU,但支持的是Intel家的GPU。Intel家的GPU,应当不用报太多期待了。

为了支持更丰富的硬件类型,可以将OpenVINO自带的预训练模型 转为ONNX格式,然后在做其他处理。

OpenVINO模型导出为ONNX

OpenVINO优化后的预训练模型无法直接转换为ONNX。不过好在Intel有提供模型的训练和导出工具,利用OpenVINO的训练工具导出ONNX

OpenVINO用于训练和导出的库为: https://github.com/openvinotoolkit/training_extensions 。

具体的操作方式参见项目的具体说明文档。

对照人脸检测的文档,导出人脸检测对应ONNX模型: https://github.com/openvinotoolkit/training_extensions/tree/develop/models/object_detection/model_templates/face-detection

注:导出目录里有 export/,export/alt_ssd_export/ 两种模型。其中 export/alt_ssd_export/ 包含了OpenVINO特有的实现,在转换为其他推理引擎模型时会失败,因此后续工作使用 export/ 中的模型。

使用TVM对ONNX模型进行优化

针对TVM的VM进行优化

对于存在动态shape的模型,TVM无法进行编译。很不幸的是OpenVINO中物体检测相关的模型都存在动态shape。在TVM无法编译的情况下,可使用TVM的VM进行执行。

  • 注:
    • 关于VM的相关内容请阅读: https://tvm.apache.org/docs/dev/virtual_machine.html
    • TVM的文档比较欠缺(特别是VM相关的内容)。不过好在项目还在快速迭代过程中,提交的issue很快就可以得到回复。
    • 根据测试,使用VM模式,在CPU上TVM的速度甚至比用 ONNXRuntime 还要慢不少。不知道是否是跑在虚拟机上的关系。
import onnx
import time
import tvm
import numpy as np
import tvm.relay as relay
target = 'llvm -mcpu=skylake'
model_path = 'face-detection-0200.onnx'
onnx_model = onnx.load(model_path)
shape = [1,3,256,256]
input_name = "image"
shape_dict = {
        input_name: shape,
        }
mod, params = relay.frontend.from_onnx(onnx_model, shape_dict)
print(relay.transform.DynamicToStatic()(mod))
with tvm.transform.PassContext(opt_level=3):
    executable = relay.vm.compile(mod, target="llvm", target_host=None, params=params)
code, lib = executable.save()
with open("code.ro", "wb") as fo:
    fo.write(code)
lib.export_library("lib.so")

针对TVM进行编译和优化

如果你的模型可以正常编译,那就没必要采用VM模式了。直接编译理论上优化效果要好很多。这里采用的是TVM范例中给出的图片分类模型。

一个完整的模型优化和执行可以参考官方文档:Compiling and Optimizing a Model with the Python AutoScheduler

import onnx
import time
import tvm
import numpy as np
import tvm.relay as relay
target = 'llvm'
model_name = 'mobilenetv2'
model_path = f'{model_name}.onnx'
onnx_model = onnx.load(model_path)
mod, params = relay.frontend.from_onnx(onnx_model)
with relay.build_config(opt_level=3):
    graph, lib, params = relay.build(mod, target, params=params)
path_lib = f"./{model_name}.so"
lib.export_library(path_lib)
fo=open(f"./{model_name}.json","w")
fo.write(graph)
fo.close()
fo=open("./{model_name}.params","wb")
fo.write(relay.save_param_dict(params))
fo.close()

VM模式下加载和运行优化好的模型

加载前面导出的模型,并执行。


import onnx
import time
import tvm
import numpy as np
import tvm.relay as relay
def vmobj_to_array(o, dtype=np.float32):
    if isinstance(o, tvm.nd.NDArray):
        return [o.asnumpy()]
    elif isinstance(o, tvm.runtime.container.ADT):
        result = []
        for f in o:
            result.extend(vmobj_to_array(f, dtype))
        return result
    else:
        raise RuntimeError("Unknown object type: %s" % type(o))
shape = [1, 3, 224, 224]
model_path = 'face-detection-0200'
loaded_lib = tvm.runtime.load_module(f"{model_path}.tvm.so")
loaded_code = bytearray(open(f"{model_path}.tvm.code", "rb").read())
exe = tvm.runtime.vm.Executable.load_exec(loaded_code, loaded_lib)
ctx = tvm.cpu()
vm = tvm.runtime.vm.VirtualMachine(exe, ctx)
data = np.random.uniform(size=shape).astype("float32")
out = vm.run(data)
out = vmobj_to_array(out)
print(out)